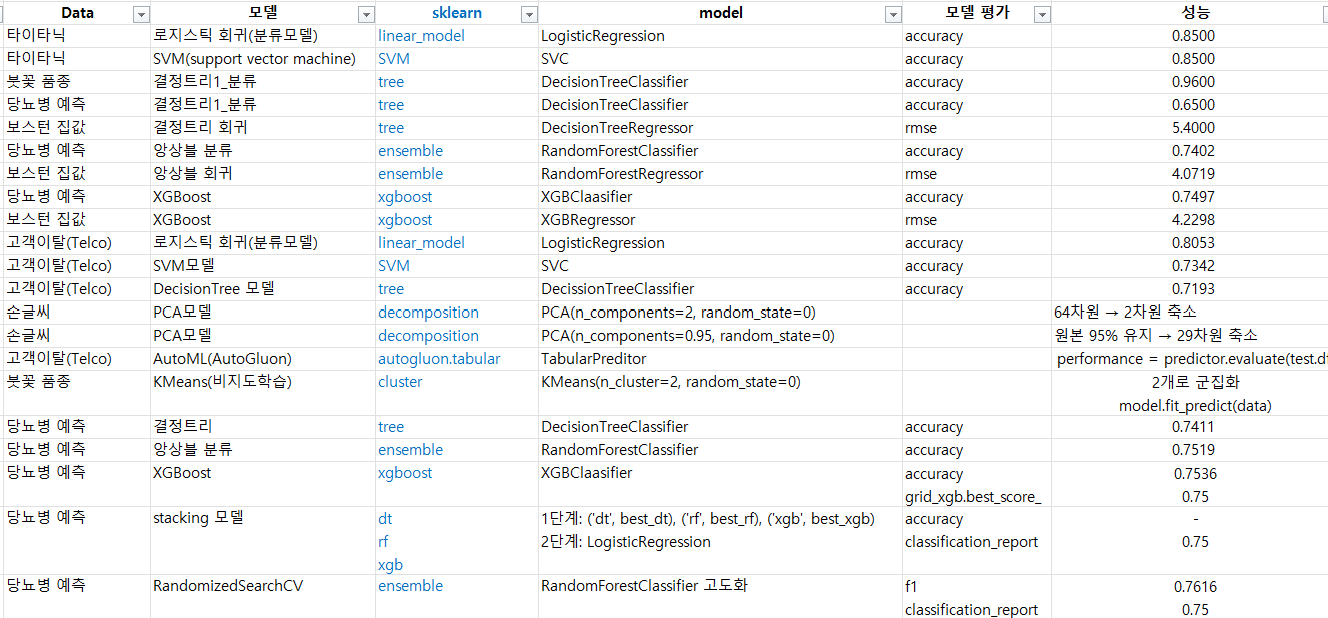
이번 수업에서는 머신러닝 모델의 성능을 평가하고, 교차검증과 GridSearchCV를 활용해 모델을 개선하는 방법을 학습했다. 단순히 정확도가 높은 모델보다 실제 상황에서 믿고 사용할 수 있는 모델을 선택하는 것이 중요하다는 점을 이해했다.
1. 혼동행렬(Confusion Matrix)
분류 모델의 예측 결과는 네 가지로 구분된다.
| 구분 | 의미 |
|---|---|
| TP | 실제 양성을 양성으로 예측 |
| TN | 실제 음성을 음성으로 예측 |
| FP | 실제 음성을 양성으로 잘못 예측 |
| FN | 실제 양성을 음성으로 잘못 예측 |
2. Accuracy, Recall, Precision, F1 Score
정확도(Accuracy)가 높다고 반드시 좋은 모델은 아니다. 예를 들어 정상인 95명과 암 환자 5명이 있는 데이터에서 모든 사람을 정상이라고 예측하면 정확도는 95%지만, 암 환자를 한 명도 발견하지 못한다.
| 평가지표 | 공식 | 핵심 의미 |
|---|---|---|
| Accuracy | (TP + TN) / 전체 | 전체 예측 중 정답 비율 |
| Recall | TP / (TP + FN) | 실제 양성을 얼마나 찾아냈는가? |
| Precision | TP / (TP + FP) | 양성 예측 중 실제 양성의 비율 |
| F1 Score | 2 × (Precision × Recall) / (Precision + Recall) | Precision과 Recall의 조화평균 |
암 진단이나 고객 이탈 예측처럼 실제 양성을 놓치는 것이 중요한 문제에서는 Recall을 중요하게 볼 수 있다. 반대로 불필요한 경고나 고객 연락을 줄여야 한다면 Precision도 중요하다. F1 Score는 두 지표의 균형을 평가할 때 활용한다.
3. 과대적합(Overfitting)
의사결정트리의 깊이가 지나치게 깊어지면 학습 데이터를 외우듯 학습할 수 있다. 이 경우 학습 데이터에서는 성능이 높지만 새로운 데이터에서는 성능이 떨어질 수 있다. 이를 과대적합이라고 한다.
따라서 학습 데이터의 성능만 보지 않고, 검증 데이터와 교차검증 결과를 함께 확인해야 한다.
4. 교차검증(Cross Validation)
cv=5는 데이터를 5개 Fold로 나누어 학습과 검증을 반복하는 5겹 교차검증을 의미한다. 각 반복에서 서로 다른 Fold를 검증에 사용하고, 나머지 Fold로 학습한다. 최종적으로 각 검증 점수의 평균을 확인해 모델의 성능을 평가한다.
5. GridSearchCV를 이용한 모델 고도화
GridSearchCV는 지정한 하이퍼파라미터 조합을 탐색하고, 교차검증 점수가 가장 좋은 설정을 찾는 도구다.
from sklearn.model_selection import GridSearchCV
from sklearn.tree import DecisionTreeClassifier

model = DecisionTreeClassifier(random_state=0)

params = {
    'max_depth': [3, 5, 10],
    'min_samples_leaf': [1, 2, 3, 5]
}

grid = GridSearchCV(
    estimator=model,
    param_grid=params,
    scoring='accuracy',
    cv=5
)

grid.fit(X_train, y_train)

print("최적 매개변수:", grid.best_params_)
print("최고 교차검증 정확도:", grid.best_score_)

best_model = grid.best_estimator_
param_grid: 탐색할 하이퍼파라미터와 후보값cv=5: 5겹 교차검증best_params_: 최적 매개변수 조합best_score_: 최적 조합의 평균 교차검증 점수best_estimator_: 최적 설정이 적용된 모델
참고로 min_samples_leaf는 Decision Tree와 Random Forest에서 사용하는 매개변수다. XGBoost에서는 지원되지 않으므로 해당 모델의 매개변수에 맞춰 탐색 범위를 설정해야 한다.
6. K-Means와 Decision Tree의 공통점
K-Means에서는 군집 수 K를 검토하고, Decision Tree에서는 트리 깊이 등을 조절한다. 두 경우 모두 모델의 복잡도를 적절하게 설정하는 것이 중요하다. 다만 Elbow Method는 군집 수를 검토하는 방법이고, 트리의 최적 깊이는 검증 성능 등을 통해 판단하므로 두 방법이 동일한 것은 아니다.
이번 수업의 핵심 정리
- Accuracy만으로 모델의 성능을 판단하지 않는다.
- Recall은 실제 양성을 찾아내는 능력, Precision은 양성 예측의 정확성을 나타낸다.
- F1 Score는 Precision과 Recall의 균형을 평가한다.
- 과대적합을 방지하려면 검증 데이터와 교차검증을 활용한다.
- GridSearchCV로 하이퍼파라미터를 탐색하고 최적 모델을 선택할 수 있다.
머신러닝은 단순히 모델을 만드는 과정이 아니라, 모델이 새로운 데이터에서도 믿을 만한 결과를 내는지 검증하는 과정이다.
#머신러닝 #AI캠프 #모델평가 #ConfusionMatrix #Accuracy #Recall #Precision #F1Score #CrossValidation #GridSearchCV #Overfitting
```