이번 주 학습에서는 자연어처리(NLP)의 핵심 개념부터 전통적인 텍스트 분석 기법, 순환신경망(RNN), Transformer, BERT, GPT, SentenceTransformer까지 자연어처리 전반에 대한 이론과 실습을 집중적으로 학습했다.
단순히 텍스트 데이터를 다루는 수준을 넘어 컴퓨터가 인간의 언어를 어떻게 숫자로 변환하고, 문맥을 이해하며, 새로운 문장을 생성하는지 전체적인 과정을 살펴볼 수 있었던 의미 있는 한 주였다.
특히 기존 머신러닝 기반 NLP와 딥러닝 기반 NLP의 차이점을 비교하면서 최근 생성형 AI 기술의 기반이 되는 Transformer 구조와 대규모 언어 모델(LLM)의 작동 원리를 이해하는 계기가 되었다.
1. 자연어처리(NLP) 기본 프로세스
자연어처리(Natural Language Processing)는 인간이 사용하는 언어를 컴퓨터가 이해하고 분석하거나 생성할 수 있도록 처리하는 기술이다.
자연어처리는 일반적으로 다음과 같은 흐름으로 진행된다.
데이터 수집
    ↓
데이터 전처리
    ↓
토큰화(Tokenization)
    ↓
임베딩(Embedding)
    ↓
모델 학습 및 추론
    ↓
목적에 맞는 결과 생성
텍스트 데이터는 숫자 형태가 아니기 때문에 머신러닝이나 딥러닝 모델이 직접 이해할 수 없다. 따라서 텍스트를 정제하고 토큰 단위로 나눈 뒤, 모델이 처리할 수 있는 숫자 벡터로 변환하는 과정이 필요하다.
이번 학습을 통해 전처리, 토큰화, 임베딩이 NLP 전체 과정에서 얼마나 중요한 역할을 하는지 이해할 수 있었다.
2. 토큰화(Tokenization)
토큰화는 문장을 의미 있는 단위인 토큰(Token)으로 나누는 과정이다. 토큰은 문장, 단어, 형태소, 서브워드 등 다양한 단위가 될 수 있다.
2-1. 영어 토큰화
영어는 문장과 단어를 기준으로 나누는 방식이 대표적이다. NLTK 라이브러리를 활용하면 다음과 같이 구현할 수 있다.
# NLTK 라이브러리
import nltk

from nltk.tokenize import sent_tokenize, word_tokenize

# 분석할 문장
text = "Natural Language Processing is interesting. AI is changing the world."

# 문장 단위 토큰화
sentences = sent_tokenize(text)

# 단어 단위 토큰화
words = word_tokenize(text)

print(sentences)
print(words)sent_tokenize(): 문장 단위로 분리word_tokenize(): 단어 단위로 분리
2-2. 한글 토큰화
한글은 조사와 어미가 결합하는 교착어의 특성을 가지고 있기 때문에 단순히 공백을 기준으로 단어를 나누는 것만으로는 의미를 충분히 분석하기 어렵다.
따라서 형태소 분석기를 활용하여 문장을 형태소 단위로 분리하고 품사를 분석하는 과정이 중요하다.
주요 형태소 분석 도구
- Mecab : 형태소 분석 및 품사 태깅에 활용
- Okt(Konlpy) : 한국어 형태소 분석과 정규화 등에 활용
주요 분석 기능
morphs(): 형태소 단위 분리nouns(): 명사 추출pos(): 형태소와 품사 정보 추출
from konlpy.tag import Okt

okt = Okt()

text = "자연어처리와 인공지능 기술을 공부하고 있습니다."

# 형태소 분리
print(okt.morphs(text))

# 명사 추출
print(okt.nouns(text))

# 품사 태깅
print(okt.pos(text))
한글 NLP에서는 형태소 분석 결과가 이후 단어 빈도 분석이나 텍스트 분류 등의 결과에 영향을 줄 수 있다는 점을 이해하게 되었다.
3. 임베딩(Embedding)
임베딩은 텍스트를 컴퓨터가 처리할 수 있는 숫자 벡터로 변환하는 과정이다. 단어 또는 문장의 의미와 특성을 수치적으로 표현하는 것이 핵심이다.
임베딩은 크게 희소 표현(Sparse Representation)과 밀집 표현(Dense Representation)으로 구분할 수 있다.
3-1. 희소 표현(Sparse Representation)
희소 표현은 전체 단어 사전을 기준으로 벡터를 생성하며, 실제로 단어가 등장한 위치를 제외하면 대부분의 값이 0으로 구성된다.
대표적인 방법
- CountVectorizer
- TF-IDF Vectorizer
특징
- 단어의 등장 빈도나 중요도를 수치로 표현한다.
- 벡터의 대부분이 0으로 구성될 수 있다.
- 단어 간 문맥과 의미적 유사성을 직접 표현하기 어렵다.
- 단어 사전이 커질수록 벡터 차원이 증가한다.
3-2. 밀집 표현(Dense Representation)
밀집 표현은 단어 또는 문장의 의미적 특성을 비교적 적은 차원의 실수 벡터로 압축하여 표현하는 방식이다.
고양이 → [0.91, 0.35, 0.12, ...]
강아지 → [0.33, 0.10, 0.85, ...]
실제 임베딩 벡터의 각 숫자가 사람이 이해할 수 있는 명확한 의미를 직접 나타내는 것은 아니다. 모델이 학습한 의미적 관계와 문맥적 특성이 벡터 공간에 반영된 결과다.
최근 BERT, SentenceTransformer, LLM 등의 기술에서는 이러한 밀집 벡터 표현이 중요한 역할을 한다.
4. CountVectorizer와 TF-IDF
전통적인 머신러닝 기반 NLP에서 자주 사용하는 텍스트 벡터화 방법으로 CountVectorizer와 TF-IDF를 학습했다.
4-1. CountVectorizer
CountVectorizer는 문서 내에서 각 단어가 등장한 횟수를 기준으로 텍스트를 숫자 벡터로 변환하는 방법이다.
장점
- 구현이 간단하다.
- 단어 등장 빈도를 직관적으로 확인할 수 있다.
- 결과를 해석하기 쉽다.
단점
- 단어의 중요도를 구분하지 못한다.
- 자주 등장하는 일반적인 단어가 높은 값을 가질 수 있다.
- 단어 간 문맥과 의미적 관계를 반영하지 못한다.
4-2. TF-IDF
TF-IDF(Term Frequency-Inverse Document Frequency)는 단어의 등장 빈도와 전체 문서에서의 등장 비율을 함께 고려하여 단어의 중요도를 계산하는 방법이다.
기본 공식
TF-IDF = TF × IDFTF(Term Frequency)는 특정 문서에서 단어가 얼마나 자주 등장하는지를 나타내고, IDF(Inverse Document Frequency)는 전체 문서에서 해당 단어가 얼마나 드물게 등장하는지를 나타낸다.
IDF 계산 예시
IDF(t) = ln((1 + N) / (1 + df(t))) + 1- N : 전체 문서의 개수
- df(t) : 해당 단어가 등장한 문서의 개수
- ln : 자연로그
실제 scikit-learn의 TfidfVectorizer는 기본 설정에서 스무딩과 정규화 등을 적용하므로 구현 환경에 따라 세부 계산식이 달라질 수 있다.
핵심은 특정 문서에서는 자주 등장하지만 전체 문서에서는 상대적으로 드물게 등장하는 단어에 더 높은 중요도를 부여한다는 것이다.
5. 코사인 유사도(Cosine Similarity)
코사인 유사도는 두 벡터 사이의 방향이 얼마나 유사한지를 측정하는 방법이다. 텍스트를 벡터로 변환한 후 문서 또는 문장 간 유사도를 비교할 때 활용한다.
계산 공식
Cosine Similarity = (A · B) / (||A|| × ||B||)- A · B : 두 벡터의 내적
- ||A|| : 벡터 A의 크기
- ||B|| : 벡터 B의 크기
결과 범위
- 1 : 두 벡터의 방향이 동일함
- 0 : 두 벡터가 직교함
- -1 : 두 벡터의 방향이 정반대임
다만 TF-IDF처럼 음수가 없는 벡터를 사용하는 경우에는 일반적으로 코사인 유사도가 0에서 1 사이에 나타난다. 유사도 0은 벡터 공간에서 직교한다는 의미이지, 언어적으로 아무런 관련이 없다는 것을 항상 보장하는 것은 아니다.
주요 활용 분야
- 챗봇의 질문 검색
- 추천 시스템
- 검색 엔진
- 문장 유사도 분석
- 문서 검색 및 분류
예를 들어 "레시피를 알려줘"와 "어떻게 만드는지 알려줘"는 표현하는 단어는 다르지만 의미적으로 유사하다. 이러한 문장들을 벡터로 변환하고 유사도를 계산하여 서로 비슷한 의미인지 판단할 수 있다는 점이 인상적이었다.
6. 문장 유사도와 SentenceTransformer
SentenceTransformer는 문장 전체를 하나의 밀집 벡터로 변환하는 데 사용하는 모델 및 라이브러리다. 일반적으로 사전학습된 Transformer 기반 모델을 활용하여 문장의 의미적 특성을 벡터 공간에 표현한다.
주요 활용 분야
- 문장 간 의미 유사도 계산
- 의미 기반 검색(Semantic Search)
- 추천 시스템
- 질문과 답변 매칭
- 검색 기반 챗봇
검색 기반 챗봇의 동작 과정
1. 사용자 질문 입력
       ↓
2. 사용자 질문 임베딩 생성
       ↓
3. 저장된 질문 임베딩과 비교
       ↓
4. 코사인 유사도 계산
       ↓
5. 가장 유사한 질문 선택
       ↓
6. 해당 질문에 연결된 답변 반환
이러한 방식은 새로운 답변을 직접 생성하는 생성형 챗봇과는 다르다. 미리 저장된 질문과 답변 중에서 가장 유사한 항목을 검색하여 반환하는 검색 기반(Retrieval-based) 챗봇 방식이다.
실습을 통해 생성형 AI 이전의 검색 기반 챗봇이 어떤 방식으로 동작하는지, 그리고 임베딩과 코사인 유사도가 실제 서비스에 어떻게 활용되는지 이해할 수 있었다.
7. 순환신경망(RNN)
RNN(Recurrent Neural Network)은 문장이나 시계열 데이터처럼 순서가 중요한 데이터를 처리하기 위해 설계된 신경망이다.
일반적인 신경망과 달리 이전 시점의 정보를 다음 시점의 계산에 전달하는 순환 구조를 가지고 있다.
핵심 특징
- 이전 시점의 정보를 은닉 상태(Hidden State)에 저장한다.
- 현재 입력과 이전 은닉 상태를 함께 사용한다.
- 순차적인 데이터 처리에 적합하다.
문장 처리 예시
오늘 → 주가가 → 몇이야?문장을 순서대로 처리하면서 이전 단어의 정보를 다음 단어의 처리에 반영한다. 따라서 단어의 순서와 앞뒤 관계가 중요한 자연어처리에 활용할 수 있다.
7-1. RNN의 한계
RNN은 순차 데이터를 처리할 수 있다는 장점이 있지만, 긴 문장을 처리할 때 몇 가지 한계가 발생한다.
- 기울기 소실(Vanishing Gradient) : 역전파 과정에서 기울기가 점점 작아져 초기 입력의 학습이 어려워질 수 있다.
- 장기 의존성(Long-term Dependency) : 문장이 길어질수록 앞부분의 중요한 정보를 충분히 유지하기 어렵다.
- 병렬 처리의 어려움 : 이전 시점의 계산이 완료되어야 다음 시점의 계산을 진행할 수 있어 병렬화에 제약이 있다.
이러한 한계를 보완하기 위해 LSTM과 GRU 같은 구조가 등장했으며, 이후 자연어처리 분야에서는 Transformer가 중요한 대안으로 자리 잡게 되었다.
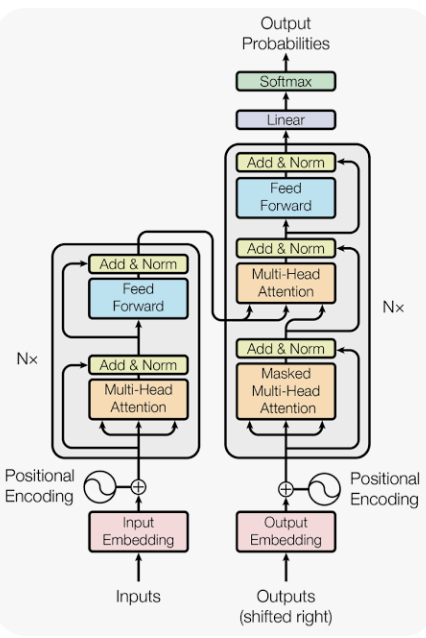
8. Transformer
Transformer는 2017년 구글 연구진이 발표한 논문 Attention Is All You Need를 통해 소개된 신경망 구조다.
기존 RNN과 달리 순차적인 처리에 의존하지 않고 Attention 메커니즘을 중심으로 입력 데이터 간의 관계를 계산한다.
Transformer의 주요 특징
- 기본 구조에서 RNN을 사용하지 않는다.
- Self-Attention을 통해 단어 간 관계를 계산한다.
- 입력 토큰을 병렬로 처리할 수 있다.
- 긴 문맥의 관계를 학습하는 데 효과적이다.
- Encoder와 Decoder 구조를 활용할 수 있다.
Transformer는 단순히 Attention만으로 구성되는 것은 아니다. Multi-Head Attention, Feed Forward Network, Residual Connection, Layer Normalization, Positional Encoding 등의 구성 요소가 함께 사용된다.
현재 GPT, BERT 등 다양한 대규모 언어 모델의 기반이 되는 구조라는 점에서 이번 주 학습 중 가장 중요한 개념 중 하나였다.
9. Self-Attention
Self-Attention은 하나의 문장 안에서 각 단어가 다른 단어들과 얼마나 관련이 있는지를 계산하는 Transformer의 핵심 메커니즘이다.
이를 위해 각 입력 벡터에서 Query(Q), Key(K), Value(V)라는 세 가지 벡터를 생성한다.
9-1. Query(Q)
현재 토큰이 다른 토큰들로부터 어떤 정보를 얻고 싶은지를 나타내는 벡터다. 쉽게 표현하면 다음과 같은 질문을 던지는 역할이다.
나에게 가장 관련성이 높은 단어는 무엇인가?
9-2. Key(K)
각 토큰이 다른 토큰의 Query와 비교될 때 사용하는 벡터다. Query와 Key의 유사도를 계산하여 관련성을 측정한다.
9-3. Value(V)
Attention 가중치를 적용하여 실제로 전달할 정보를 담고 있는 벡터다.
Scaled Dot-Product Attention 공식
Attention(Q, K, V)
= softmax(QKᵀ / √dₖ) V
Q와 K의 내적을 통해 관련성을 계산하고, 이를 Softmax 함수에 적용하여 Attention Weight를 생성한다. 이후 해당 가중치를 V에 적용하여 문맥 정보가 반영된 새로운 표현을 만든다.
이번 학습을 통해 단어를 단순히 순서대로 처리하는 방식과 달리, 문장 안의 여러 단어 간 관계를 직접 계산하는 구조가 Transformer의 핵심이라는 점을 이해할 수 있었다.
10. BERT
BERT(Bidirectional Encoder Representations from Transformers)는 구글이 발표한 사전학습 언어 모델로, Transformer의 Encoder 구조를 기반으로 한다.
주요 특징
- Transformer Encoder 기반
- 양방향 문맥 정보 학습
- 문장 이해 및 텍스트 분류 작업에 활용
- 사전학습 후 다양한 자연어처리 작업에 Fine-Tuning 가능
10-1. MLM(Masked Language Model)
MLM은 문장 내 일부 토큰을 [MASK]로 가린 뒤, 주변 문맥을 활용하여 원래 단어를 예측하는 학습 방식이다.
비행기를 타러 공항을 가는데
[MASK]가 너무 막혀서 결국 늦었다.
모델은 앞뒤 문맥을 함께 참고하여 MASK 위치에 들어갈 단어를 예측한다. 이를 통해 양방향 문맥 정보를 학습할 수 있다.
10-2. NSP(Next Sentence Prediction)
NSP는 두 문장이 실제로 이어지는 관계인지 판단하는 학습 방식이다.
- 두 문장이 실제로 이어지는 관계인지 판단
- 문장 간 관계를 학습하는 데 활용
MLM과 NSP는 원본 BERT의 대표적인 사전학습 방식이다. 다만 이후 등장한 일부 BERT 계열 모델은 NSP를 사용하지 않는 등 학습 방식을 개선하거나 변경하기도 했다.
11. GPT
GPT(Generative Pre-trained Transformer)는 Transformer의 Decoder 구조를 기반으로 하는 생성형 언어 모델이다.
주요 특징
- Transformer Decoder 기반
- 이전 토큰을 바탕으로 다음 토큰 예측
- 문장 생성 및 자연어 응답에 강점
- 대규모 텍스트 데이터를 활용한 사전학습
다음 토큰 예측 예시
입력: 비행기를 타기 위해

예측: 공항에 갔다.
다음: 탑승 수속을 진행했다.
GPT는 앞에서 생성된 토큰을 바탕으로 다음 토큰을 순차적으로 예측하면서 문장을 생성한다.
BERT와 GPT의 차이
- BERT : 양방향 문맥을 활용하는 Encoder 기반 모델로 문장 이해 작업에 강점
- GPT : 이전 토큰을 바탕으로 다음 토큰을 예측하는 Decoder 기반 모델로 문장 생성에 강점
간단히 표현하면 BERT는 문맥을 이해하는 작업에, GPT는 문장을 생성하는 작업에 강점을 가진다고 이해할 수 있었다. 다만 실제 활용 분야는 모델의 학습 방식과 목적에 따라 다양하게 확장된다.
12. Hugging Face와 추론(Inference)
Hugging Face는 사전학습된 다양한 AI 모델과 데이터셋을 제공하는 플랫폼이다. Transformers 라이브러리를 활용하면 복잡한 모델 구조를 처음부터 구현하지 않고도 이미 학습된 모델을 불러와 자연어처리 작업에 활용할 수 있다.
주요 활용 기능
- 텍스트 분류(Text Classification)
- 감성 분석(Sentiment Analysis)
- 문장 생성(Text Generation)
- 질문 응답(Question Answering)
- 개체명 인식(Named Entity Recognition)
Pipeline을 활용한 텍스트 분류 예시
from transformers import pipeline

# 텍스트 분류 파이프라인 생성
classifier = pipeline("text-classification")

# 분석할 문장
text = "This movie was very interesting."

# 추론 실행
result = classifier(text)

# 결과 출력
print(result)
Pipeline은 작업 유형에 맞는 모델과 토크나이저를 연결하여 추론 과정을 간단하게 실행할 수 있도록 지원한다. 별도의 모델을 지정하지 않으면 작업 유형에 맞는 기본 모델을 사용할 수 있다.
추론(Inference)은 학습이 완료된 모델을 활용하여 새로운 입력 데이터에 대한 예측 결과를 생성하는 과정이다.
13. 실습 내용
이번 주에는 NLP의 이론을 학습하는 것에 그치지 않고 실제 텍스트 데이터를 활용한 다양한 실습을 진행했다.
13-1. 텍스트 분석 및 시각화
- 텍스트 데이터 전처리
- 단어 빈도수 분석
- Counter를 활용한 빈도 계산
- WordCloud를 활용한 단어 시각화
13-2. 추천 시스템
- CountVectorizer 기반 텍스트 벡터화
- TF-IDF 기반 단어 중요도 계산
- 코사인 유사도를 활용한 유사 문서 검색
13-3. 감성 분석
- 네이버 영화 리뷰 데이터(NSMC)
- IMDB 영화 리뷰 데이터
- BERT 기반 텍스트 분류 모델
- RNN 기반 감성 분류 모델
13-4. 챗봇 구현
- SentenceTransformer를 활용한 문장 임베딩
- 문장 임베딩 저장
- 코사인 유사도를 활용한 질문 검색
- 가장 유사한 질문에 대응하는 답변 반환
특히 문장 임베딩과 유사도 검색을 연결하여 사용자의 질문에 적합한 답변을 찾는 챗봇의 기본 구조를 구현해 본 것이 의미 있었다.
14. 9주차 학습 회고
이번 주는 생성형 AI를 구성하는 핵심 기술들을 연결해서 이해할 수 있었던 한 주였다. 과거의 CountVectorizer와 TF-IDF 같은 통계 기반 방법부터 RNN, Transformer, BERT, GPT까지 NLP 기술이 발전해 온 흐름을 따라가며 학습하니 각 기술이 왜 등장했고 어떤 문제를 해결하려고 했는지 자연스럽게 이해할 수 있었다.
특히 Transformer의 Self-Attention 구조와 BERT, GPT의 학습 원리를 배우면서 현재 사용하고 있는 ChatGPT, Claude, Gemini와 같은 LLM이 어떤 기술적 기반 위에서 동작하는지 이해하는 데 도움이 되었다.
또한 SentenceTransformer와 코사인 유사도를 활용한 챗봇 구현 실습을 통해 실제 검색 기반 AI 서비스가 어떤 구조로 만들어지는지 경험할 수 있었다. 단순히 AI에게 질문하고 답변을 받는 것에서 벗어나, 사용자의 질문을 벡터로 변환하고 유사한 데이터를 검색하는 과정을 직접 살펴볼 수 있었다.
아직 Transformer의 내부 구조와 Attention 수식을 완벽하게 이해했다고 보기는 어렵다. 하지만 NLP의 전체 흐름을 파악했다는 점에서 이번 주 학습은 의미가 컸다. 앞으로는 이론을 반복해서 읽는 것보다 직접 코드를 실행하고 결과를 비교하면서 각 기술의 차이를 확실하게 익히는 데 집중해야겠다.
15. 다음 주 학습 목표
- Transformer 전체 구조 복습
- Self-Attention 수식과 계산 과정 이해 심화
- BERT Tokenizer 실습 복습
- Hugging Face Fine-Tuning 실습
- SentenceTransformer 기반 챗봇 프로젝트 정리
- NLP 전체 학습 흐름과 주요 용어 다시 정리하기
이번 주 학습을 통해 자연어처리의 기본 원리부터 최신 생성형 AI의 기반 기술까지 전체적인 흐름을 이해할 수 있었다. 다음 주에는 배운 내용을 실제 프로젝트에 적용할 수 있도록 복습과 실습을 병행하며 학습을 이어가고자 한다.
#AI캠프 #9주차회고 #자연어처리 #NLP #텍스트분석 #토큰화 #임베딩 #CountVectorizer #TFIDF #코사인유사도 #SentenceTransformer #RNN #Transformer #SelfAttention #BERT #GPT #HuggingFace #머신러닝 #딥러닝 #생성형AI #LLM
```