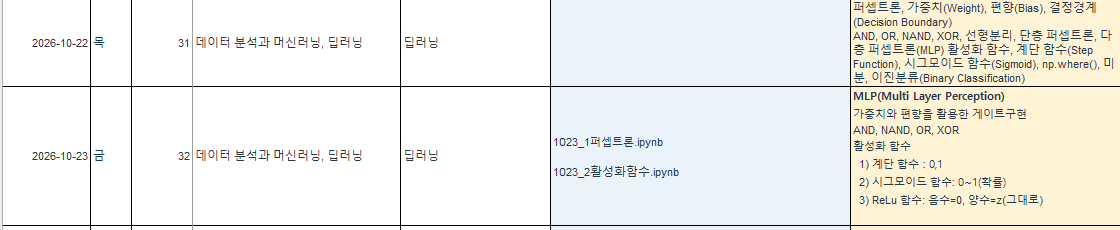
이번 주에는 머신러닝 모델을 평가하고 성능을 개선하는 방법부터 딥러닝의 기본 구조와 활성화 함수까지 학습했다. 지난주까지는 데이터를 전처리하고 모델을 학습시키는 과정에 집중했다면, 이번 주에는 한 걸음 더 나아가 모델이 얼마나 잘 예측하는지 확인하고, 더 나은 모델을 찾으며, 인공신경망이 학습하는 원리를 이해하는 과정을 경험했다.
특히 모델을 학습시키는 것과 실제로 신뢰할 수 있는 모델을 만드는 것은 서로 다른 문제라는 점을 배웠다. 평가지표를 이해하고, 교차 검증으로 성능을 확인하고, 하이퍼파라미터를 조정하는 과정이 필요했다. 이후에는 퍼셉트론의 가중합 계산부터 XOR 문제, MLP, 시그모이드와 ReLU까지 연결하면서 딥러닝의 기초를 정리했다.
1. 머신러닝 모델의 성능을 어떻게 평가할까?
모델을 학습시켰다고 해서 예측 성능이 좋다고 단정할 수는 없다. 실제 정답과 모델의 예측 결과를 비교하고, 문제의 특성에 맞는 평가 지표를 선택해야 한다. 이번 주에는 분류 모델의 성능을 평가하는 여러 지표를 복습했다.
① 혼동행렬(Confusion Matrix)
혼동행렬은 실제 정답과 모델의 예측 결과를 비교한 표다. 이진 분류에서는 다음 네 가지 결과를 구분한다.
- TP(True Positive): 실제 양성을 양성으로 예측
- TN(True Negative): 실제 음성을 음성으로 예측
- FP(False Positive): 실제 음성을 양성으로 잘못 예측
- FN(False Negative): 실제 양성을 음성으로 잘못 예측
혼동행렬을 이해하면 단순히 정답을 맞힌 비율만 확인하는 것이 아니라 어떤 유형의 오류가 발생했는지도 파악할 수 있다.
② 주요 평가 지표
- Accuracy(정확도): 전체 데이터 중 올바르게 예측한 비율
- Precision(정밀도): 양성이라고 예측한 데이터 중 실제 양성의 비율
- Recall(재현율): 실제 양성 데이터 중 양성으로 찾아낸 비율
- F1 Score: 정밀도와 재현율의 조화평균
Accuracy = (TP + TN) / (TP + TN + FP + FN)
Precision = TP / (TP + FP)
Recall = TP / (TP + FN)
F1 Score = 2 × Precision × Recall / (Precision + Recall)
예를 들어 전체 환자 중 실제 환자가 5%뿐인 데이터에서 모든 사람을 정상이라고 예측하면 정확도는 95%가 될 수 있다. 하지만 환자를 한 명도 찾아내지 못하므로 재현율은 0%다. 이 사례를 통해 정확도 하나만으로 모델의 성능을 판단해서는 안 된다는 점을 이해했다.
③ 과적합(Overfitting)
과적합은 모델이 학습 데이터의 특징뿐 아니라 불필요한 세부 패턴까지 지나치게 학습해 새로운 데이터에서 성능이 떨어지는 현상이다. 학습 데이터에서 성능이 높더라도 실제 데이터에서 좋은 결과를 보장하지는 않는다.
따라서 모델의 성능을 판단할 때는 학습 데이터의 결과만 확인하지 않고, 검증 데이터와 테스트 데이터의 결과를 구분해서 살펴봐야 한다.
2. 교차 검증과 하이퍼파라미터 최적화
모델의 성능을 안정적으로 평가하고 개선하기 위해 교차 검증과 하이퍼파라미터 탐색 방법을 학습했다. 모델마다 조정할 수 있는 설정값이 다르며, 어떤 값을 선택하느냐에 따라 예측 결과도 달라진다.
① K-Fold 교차 검증(Cross Validation)
5-Fold 교차 검증은 데이터를 5개 부분으로 나누고, 그중 4개 부분으로 학습하고 나머지 1개 부분으로 검증하는 과정을 반복한다. 각 부분이 한 번씩 검증 데이터가 되도록 총 5회 평가한다.
교차 검증은 특정 데이터 분할 하나에만 의존하는 것을 줄여 모델의 성능을 비교하는 데 도움을 준다. 다만 교차 검증 점수와 최종 테스트 데이터 점수는 서로 다른 결과라는 점도 중요하다.
② GridSearchCV
GridSearchCV는 지정한 하이퍼파라미터 조합을 모두 탐색하는 방법이다. 예를 들어 의사결정나무 회귀 모델에서 다음 설정을 조정할 수 있다.
max_depth: 트리의 최대 깊이min_samples_leaf: 리프 노드에 필요한 최소 샘플 수cv=5: 5-Fold 교차 검증
이번 실습에서는 DecisionTreeRegressor에 18개의 최대 깊이 조건과 4개의 리프 노드 조건을 적용했다. 총 72개 조합을 탐색하고, 각 조합에 5-Fold 교차 검증을 적용하면 총 360회의 모델 학습이 수행된다.
③ RandomizedSearchCV
RandomizedSearchCV는 전체 조합을 모두 탐색하는 대신, 설정한 탐색 공간에서 지정한 횟수만큼 조합을 무작위로 선택해 평가한다.
이번에는 RandomForestRegressor를 이용해 다음과 같은 설정을 탐색했다.
n_estimators: 100, 200, 300, 400, 500max_depth: 3부터 20까지min_samples_leaf: 2, 3, 4, 5n_iter=60: 60개 조합 탐색cv=5: 5-Fold 교차 검증
전체 조합은 360개이지만, RandomizedSearchCV는 이 중 60개 조합을 탐색한다. 5-Fold 교차 검증을 적용하면 일반적으로 300회의 학습을 수행한다. 전체 탐색보다 계산량을 줄이면서 유망한 모델을 찾을 수 있다는 점이 특징이다.
④ RMSE와 평가 점수의 방향
회귀 모델은 실제값과 예측값의 차이를 이용해 성능을 평가한다. 이번 실습에서는 RMSE(Root Mean Squared Error)를 사용했다. RMSE는 예측 오차의 크기를 나타내며, 일반적으로 값이 작을수록 예측 성능이 좋다.
scikit-learn의 scoring='neg_root_mean_squared_error'는 점수가 클수록 좋도록 RMSE에 음수를 붙여 반환한다. 따라서 best_score_가 0에 가까울수록 RMSE가 작다는 의미다.
또한 best_params_는 최적의 하이퍼파라미터 조합, best_score_는 해당 조합의 교차 검증 점수, best_estimator_는 최적 설정으로 학습된 모델을 의미한다.
3. 실습 중 발생한 오류와 배운 점
이번 주에는 모델의 개념을 익히는 것뿐 아니라 실제 코드를 실행하면서 매개변수 오류와 학습 시간 문제도 경험했다. 오류가 발생했을 때 코드를 무작정 다시 실행하기보다 원인을 구분하는 것이 중요했다.
① GridSearchCV 매개변수 이름 확인
GridSearchCV를 작성하면서 param_grid를 param_gird로 잘못 입력하거나 cv를 대문자로 작성하면 매개변수를 인식하지 못하는 오류가 발생한다. 라이브러리에서 사용하는 매개변수 이름과 대소문자를 정확히 입력해야 한다.
② 모델마다 지원하는 하이퍼파라미터가 다르다
XGBoost 모델을 학습할 때 min_samples_leaf가 사용되지 않는다는 경고가 발생했다. 이 매개변수는 의사결정나무나 랜덤 포레스트에서 사용하지만, XGBoost 분류 모델에서는 동일한 이름의 매개변수로 적용되지 않는다.
XGBoost에서는 역할이 일부 비슷한 min_child_weight 등을 검토할 수 있지만, 두 매개변수가 완전히 같은 의미를 갖는 것은 아니다. 모델마다 지원하는 설정값과 의미를 확인해야 한다.
③ 탐색 결과가 수업 예제와 다를 수 있다
RandomizedSearchCV에서 최적 모델이 예상과 다르게 나오는 경우에는 다음 항목을 확인해야 한다.
- 학습 데이터와 전처리 결과가 동일한가?
- 하이퍼파라미터 탐색 범위가 같은가?
n_iter와random_state가 같은가?- 평가 지표와 교차 검증 설정이 같은가?
- 라이브러리 버전과 모델 설정이 다른가?
특히 난수 시드를 고정하더라도 데이터와 탐색 조건이 다르면 결과가 달라질 수 있다. 코드의 실행 결과를 비교할 때는 최적 모델의 이름만 확인하기보다 최적 매개변수와 검증 점수까지 함께 확인해야 한다.
4. 딥러닝의 출발점, 퍼셉트론
머신러닝 모델 평가와 최적화를 학습한 뒤에는 딥러닝의 기본 원리를 살펴봤다. 딥러닝은 여러 계층으로 구성된 인공신경망을 활용하며, 그 기본 계산 단위를 이해하는 것이 퍼셉트론 학습의 출발점이다.
① 퍼셉트론(Perceptron)
퍼셉트론은 여러 입력값에 가중치를 적용하고 편향을 더해 가중합을 계산한다.
z = w₁x₁ + w₂x₂ + b
- x: 입력값
- w: 가중치
- b: 편향
- z: 가중합 결과
이 계산 결과를 활성화 함수에 전달해 최종 출력을 결정한다. 단순한 퍼셉트론은 선형 결정경계를 사용하므로 직선 하나로 분리할 수 있는 문제를 해결할 수 있다.
② 논리 게이트와 XOR 문제
AND, OR, NAND는 단층 퍼셉트론으로 구현할 수 있는 대표적인 논리 게이트다. 반면 XOR는 입력이 서로 다를 때만 1을 출력하는데, 이 데이터는 직선 하나로 완벽하게 분리할 수 없다.
이 한계를 해결하기 위해 여러 계층을 연결한 MLP(Multi-Layer Perceptron)를 사용한다. 은닉층에 비선형 활성화 함수를 적용하면 XOR와 같은 비선형 문제도 학습할 수 있다.
③ 활성화 함수
활성화 함수는 신경망이 복잡한 패턴을 학습하도록 돕는다. 이번 주에는 계단 함수, 시그모이드, ReLU를 중심으로 각 함수의 역할을 정리했다.
- 계단 함수: 기준값에 따라 0 또는 1을 출력한다.
- 시그모이드: 입력값을 0과 1 사이로 변환하며 이진 분류 출력층에 자주 사용한다.
- ReLU: 음수는 0, 양수는 그대로 출력하며 은닉층에서 널리 사용한다.
Sigmoid(z) = 1 / (1 + e-z)
ReLU(z) = max(0, z)
시그모이드는 입력값을 확률처럼 해석할 수 있는 범위로 변환하지만, 깊은 신경망에서는 기울기 소실 문제가 발생