[6주차 회고] AI 데이터분석 캠프 (10/12 ~ 10/16)
이번 주는 머신러닝 모델을 단순히 사용하는 것을 넘어, 알고리즘이 어떤 원리로 예측하고 서로 어떤 차이가 있는지 이해하는 데 집중한 한 주였다.
XGBoost와 Boosting, Stacking, PCA, AutoML, 그리고 비지도학습과 K-Means까지 다양한 개념을 학습했다. 특히 분류와 회귀 실습을 직접 진행하면서 모델을 학습시키는 것만큼이나 평가 지표를 정확히 이해하는 것이 중요하다는 점을 느꼈다.
1. 이번 주 학습 키워드
- 1.1. XGBoost와 Boosting
- 1.2. Residual(잔차)
- 1.3. Stacking과 Meta Model
- 1.4. Lasso, Ridge, Regularization
- 1.5. PCA와 Principal Component
- 1.6. Explained Variance Ratio
- 1.7. Curse of Dimensionality
- 1.8. AutoML과 AutoGluon
- 1.9. Accuracy와 Balanced Accuracy
- 1.10. 지도학습과 비지도학습
- 1.11. Clustering과 K-Means
- 1.12. Euclidean Distance와 Centroid
- 1.13. Elbow Method와 GMM
2. 실습 결과 한눈에 비교하기
이번 주에 수행한 5개 실습 노트북에서 최종 성능 평가 결과를 확인했다. 아래 표는 각 실습의 모델, 평가 데이터에서의 성능, 그리고 실습을 통해 알 수 있었던 차별점을 한곳에 정리한 것이다.
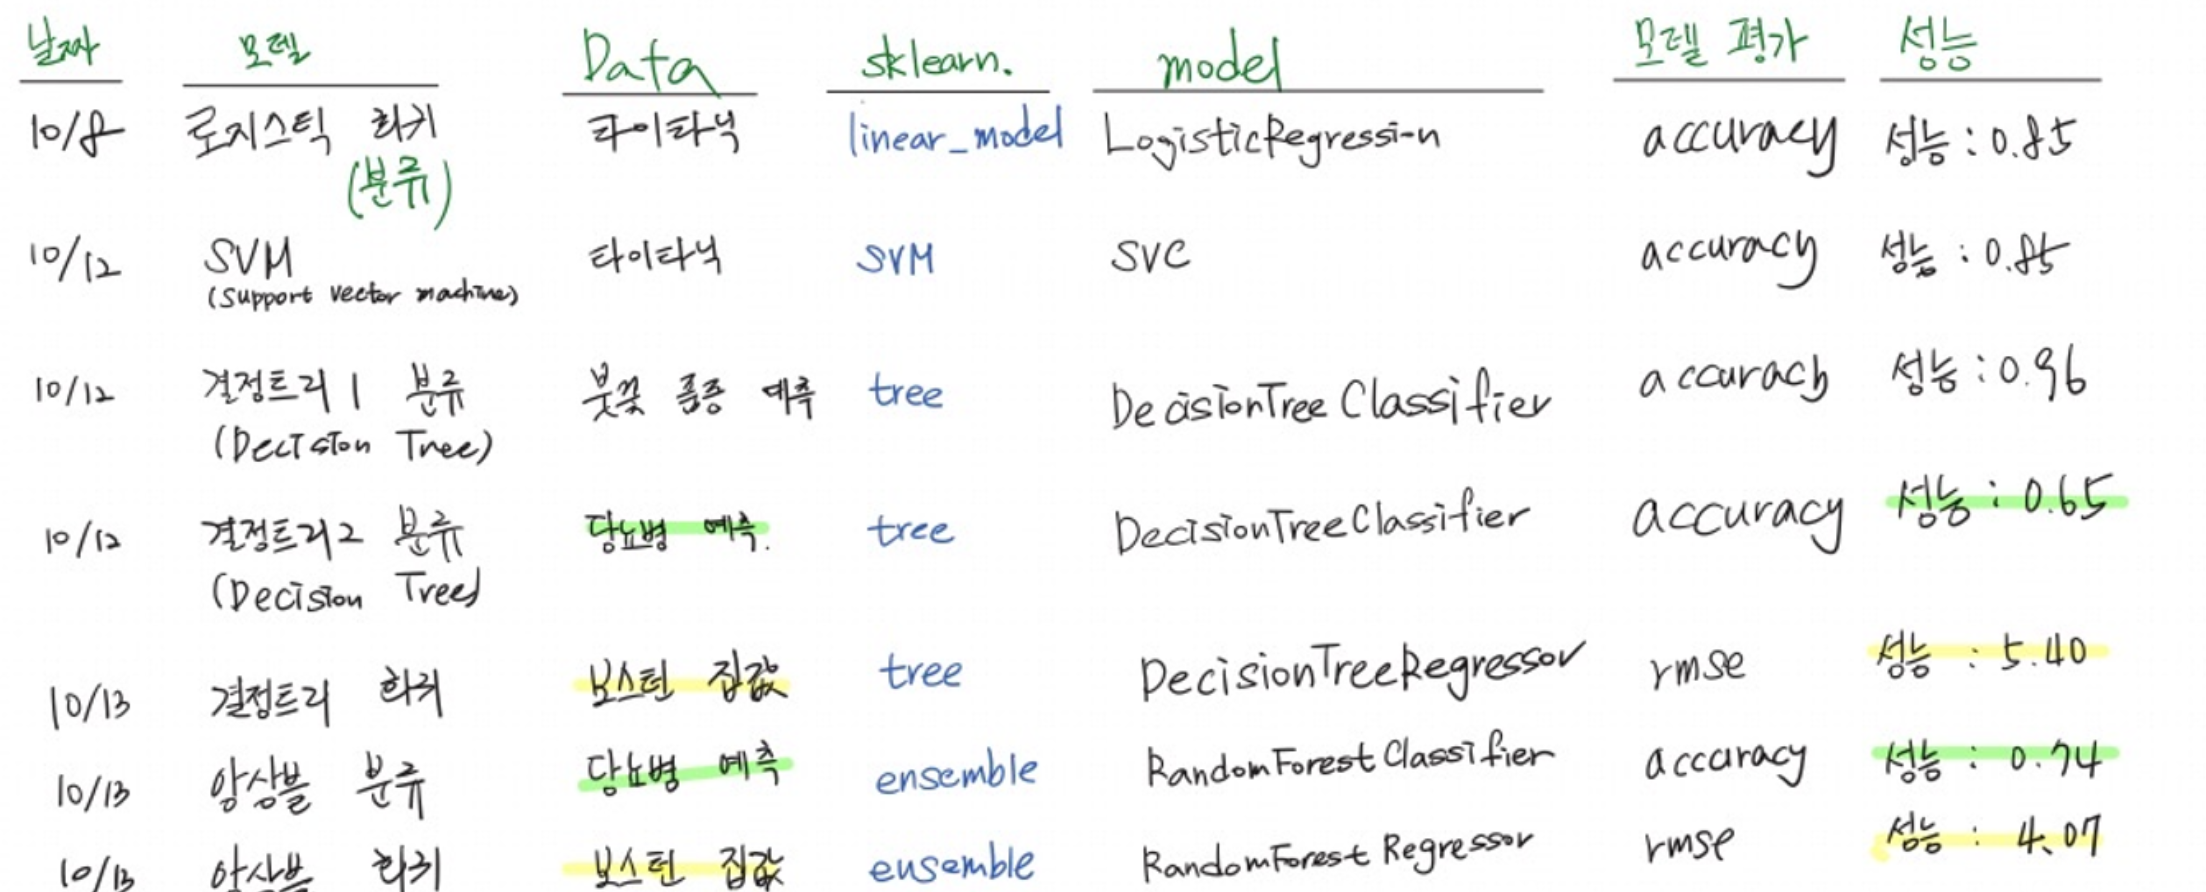
성능 수치는 각 노트북에 기록된 평가 결과를 반영했다. 분류 모델은 Accuracy, 회귀 모델은 RMSE를 사용했다. 서로 다른 데이터셋과 평가 지표를 사용했으므로 수치만으로 모든 모델의 성능을 직접 비교할 수는 없다.
3. 머신러닝은 AI가 아니라 통계학의 자동화였다
이번 주 가장 크게 느낀 점은 현재 배우는 머신러닝이 내가 생각했던 생성형 AI와는 꽤 다르다는 것이다.
ChatGPT 같은 생성형 AI는 사람처럼 생각하고 판단하는 것처럼 보이지만, 이번 주에 배운 선형회귀, 로지스틱회귀, PCA, 군집화 같은 알고리즘은 AI가 대중화되기 훨씬 전부터 존재하던 수학과 통계학의 개념이다.
결국 머신러닝은 데이터를 이용해 패턴을 학습하고 예측하는 기술이다. 사람이 직접 계산하던 통계적 분석과 예측 과정을 컴퓨터가 수행하도록 만든다는 점에서 이해의 폭이 넓어졌다.
4. XGBoost와 Boosting 이해하기
Boosting을 배울 때 처음에는 Random Forest와 무엇이 다른지 이해하기 어려웠다. 하지만 '조각상을 다듬는 과정'이라는 비유를 통해 조금 더 쉽게 이해할 수 있었다.
- 4.1. 1차 예측 수행
- 4.2. 예측 오차 확인
- 4.3. 오차를 줄이는 방향으로 다음 모델 학습
- 4.4. 예측 개선
- 4.5. 여러 단계의 결과 결합
Boosting은 이전 단계의 예측 오차를 보완하도록 모델을 순차적으로 학습하는 방식이다. XGBoost는 그래디언트 부스팅을 기반으로 학습 효율과 성능을 개선한 라이브러리다.
반면 Random Forest는 여러 결정트리를 서로 다른 표본과 특성 조합으로 학습시키고 결과를 결합한다. 두 방법 모두 여러 모델을 활용하지만, 모델을 결합하는 방식과 학습 과정이 다르다는 점이 핵심이다.
5. Stacking은 전문가 회의였다
Stacking은 서로 다른 모델의 예측 결과를 다시 학습해 최종 예측을 만드는 앙상블 기법이다. 여러 전문가가 각자의 의견을 제시하고, 마지막에 종합 판단을 내리는 회의와 비슷하다고 느꼈다.
- 5.1. Random Forest, XGBoost, Decision Tree 등 Base Model의 예측 수행
- 5.2. 각 Base Model의 예측 결과를 Meta Model의 입력으로 사용
- 5.3. Meta Model에서 최종 예측 수행
Base Model은 각자 예측을 수행하고, Meta Model은 그 예측 결과를 입력으로 받아 최종 결과를 학습한다. 분류에서는 Logistic Regression, 회귀에서는 Linear Regression 등을 메타 모델로 활용할 수 있다.
다만 여러 모델을 조합한다고 무조건 성능이 좋아지는 것은 아니다. 메타 모델이 학습할 데이터를 적절하게 구성하고, 교차검증을 활용해 과적합을 방지하는 과정도 중요하다.
6. PCA는 중요한 컬럼을 선택하는 것이 아니었다
이번 주 가장 오래 고민했던 내용은 PCA였다. 처음에는 PCA가 중요한 컬럼을 선택하는 알고리즘이라고 생각했지만, 실제로는 원본 컬럼을 그대로 고르는 방법이 아니었다.
PCA는 데이터가 분산된 방향을 찾아 새로운 축인 주성분을 생성한다. 여러 원본 특성을 조합해 더 적은 차원으로 데이터를 표현할 수 있다.
- 6.1. 64개 특성으로 구성된 원본 데이터 준비
- 6.2. PCA를 이용한 차원 축소
- 6.3. 29개 주성분으로 데이터 표현
- 6.4. 누적 설명 분산 비율 약 95% 목표
여기서 가장 인상적이었던 점은 PCA가 사람이 생각하는 의미나 중요도를 직접 판단하는 것이 아니라, 데이터의 분산을 기준으로 주성분을 구성한다는 것이다.
따라서 분산이 크다고 해서 반드시 업무적으로 중요한 정보라는 뜻은 아니다. 차원 축소를 통해 계산 부담을 줄일 수 있지만, 해석 가능성과 예측 성능도 함께 확인해야 한다.
7. AutoML은 머신러닝 자동화 도구였다
AutoGluon을 활용한 AutoML 실습에서는 머신러닝의 여러 작업을 자동화하는 과정을 살펴봤다.
- 7.1. 데이터 입력
- 7.2. 모델 학습 및 후보 모델 비교
- 7.3. 설정에 따른 모델 탐색
- 7.4. 성능 평가 및 모델 선택
기존에는 데이터 준비, 모델 선택, 하이퍼파라미터 설정, 학습, 평가를 각각 진행해야 했다. AutoML은 이러한 과정을 자동화해 여러 후보 모델을 효율적으로 비교하도록 돕는다.
다만 자동으로 선택된 모델이 모든 상황에서 최선이라고 볼 수는 없다. 평가 데이터의 구성, 데이터 누수 여부, 평가 지표, 실제 업무에서의 비용 등을 확인해야 한다.
8. Accuracy보다 Balanced Accuracy가 중요할 수도 있다
기존에는 Accuracy가 높으면 좋은 모델이라고 생각했다. 하지만 클래스별 데이터 수가 크게 다른 불균형 데이터에서는 전체 정확도만으로 모델을 평가하기 어려울 수 있다.
Balanced Accuracy는 각 클래스의 재현율을 계산한 뒤 평균을 내는 지표다. 이탈 고객이나 특정 질병 환자처럼 놓치지 않는 것이 중요한 대상을 예측할 때 유용할 수 있다.
따라서 모델을 평가할 때는 정확도 하나만 볼 것이 아니라, 문제의 목적과 데이터 분포에 따라 Precision, Recall, F1-score, Balanced Accuracy 등을 함께 살펴봐야 한다는 점을 배웠다.
9. 비지도학습과 군집화(K-Means)
이번 주 후반에는 비지도학습을 학습했다. 지도학습과 비지도학습의 가장 큰 차이는 학습 데이터에 정답(Label)이 있는지 여부다.
9.1. 지도학습
- 9.1.1. 정답이 있는 데이터 사용
- 9.1.2. 생존 여부, 이탈 여부, 합격 여부 등을 정답으로 설정
- 9.1.3. 정답을 예측하도록 학습
9.2. 비지도학습
- 9.2.1. 정답이 없는 데이터 사용
- 9.2.2. 데이터 사이의 유사성 탐색
- 9.2.3. 비슷한 데이터끼리 군집 생성
K-Means는 데이터 사이의 거리를 이용해 가까운 데이터를 같은 군집으로 묶는다. 군집 번호 0, 1, 2 자체에는 고정된 의미가 없으며, 각 군집의 특성을 분석한 뒤 사람이 의미를 해석해야 한다.
또한 군집 결과를 원본 데이터의 새로운 컬럼으로 추가해 후속 분석에 활용할 수도 있다. 다만 군집 번호를 그대로 정답으로 간주해서는 안 되며, 군집별 특성과 실제 목적에 맞는지 검토해야 한다.
10. 이번 주 가장 큰 깨달음
머신러닝은 마법 같은 AI가 아니라, 데이터 속의 패턴을 수학적으로 찾아내는 과정이다.
이번 주에는 모델 사용법 자체보다 왜 이런 알고리즘이 존재하는지, 그리고 어떤 문제를 해결하기 위해 만들어졌는지를 이해하려고 노력했다.
실습 결과를 비교하면서 같은 종류의 모델이라도 데이터에 따라 성능이 달라지고, 높은 정확도만으로 모든 모델의 우수성을 판단할 수 없다는 점도 알게 됐다.
앞으로는 단순히 코드를 실행하고 결과를 확인하는 데 그치지 않고, 데이터의 특성에 맞는 모델을 선택하고 평가 결과를 설명할 수 있는 능력을 키우고 싶다.
11. 다음 주 학습 목표
- 11.1. K-Means의 군집화 원리와 결과 해석
- 11.2. GMM과 K-Means의 차이 이해하기
- 11.3. K-Fold Cross Validation
- 11.4. GridSearchCV를 이용한 하이퍼파라미터 탐색
- 11.5. Feature Importance 확인하기
- 11.6. Explainable AI와 모델 해석
다음 주에는 단순히 코드를 따라 치는 수준을 넘어, 결과가 왜 그렇게 나오는지 스스로 설명할 수 있는 수준까지 이해하는 것이 목표다.
#AI데이터분석 #머신러닝 #6주차회고 #Python #ScikitLearn #SVM #DecisionTree #RandomForest #PCA #AutoML #AutoGluon #KMeans #데이터분석