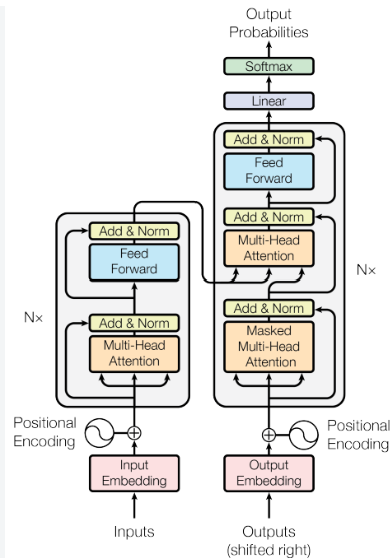
오늘 수업에서는 자연어처리(NLP)의 기본이 되는 토큰화(Tokenization), 임베딩(Embedding), 코사인 유사도(Cosine Similarity)를 중심으로 학습했다. 텍스트를 컴퓨터가 처리할 수 있는 숫자 데이터로 변환하고, 문장 사이의 의미적 유사성을 계산하는 과정은 챗봇과 추천 시스템을 구현하는 데 중요한 기반이 된다.
특히 CountVectorizer와 TF-IDF 같은 전통적인 텍스트 분석 기법부터 SentenceTransformer와 Transformer 기반 모델까지 연결해서 이해하는 것이 중요했다.
1. 자연어처리(NLP) 전체 흐름
오늘 수업 내용을 전체적으로 연결하면 다음과 같은 흐름으로 이해할 수 있다.
위 흐름은 NLP 기술을 이해하기 위한 개념적인 구조다. RNN과 Transformer는 서로 다른 신경망 구조이며, BERT와 GPT는 Transformer를 기반으로 발전한 모델 계열이다. SentenceTransformer는 문장 임베딩과 유사도 검색에 활용되는 모델 및 라이브러리다.
2. 토큰화(Tokenization)
2-1. 정의
토큰화란 텍스트를 컴퓨터가 처리할 수 있는 의미 단위(Token)로 분리하는 과정이다.
즉, 하나의 문장을 여러 개의 토큰으로 나누어 모델이 처리할 수 있도록 만드는 작업이다.
교재에서는 토큰화를 텍스트를 의미 있는 단위로 나누는 작업이라고 설명한다.
2-2. 문장 토큰화(Sentence Tokenization)
하나의 텍스트를 문장 단위로 분리하는 방법이다.
오늘 날씨가 좋다.
점심을 먹었다.

↓

[
    "오늘 날씨가 좋다.",
    "점심을 먹었다."
]
2-3. 단어 토큰화(Word Tokenization)
문장을 단어 단위로 분리하는 방법이다.
I love you

↓

["I", "love", "you"]
2-4. 형태소 토큰화(Morpheme Tokenization)
형태소는 의미를 가지는 가장 작은 언어 단위다. 한국어는 조사와 어미가 단어에 결합하는 특성이 있어 형태소 분석이 중요하다.
꽃밭에 꽃이 많이 피었다.

↓

꽃밭 / 에 / 꽃 / 이 / 많이 / 피 / 었 / 다
2-5. 주요 토큰화 도구
| 도구 | 주요 기능 |
|---|---|
| NLTK | 영어 문장 및 단어 토큰화 |
| Mecab | 한국어 형태소 분석 및 품사 태깅 |
| Okt(Konlpy) | 한국어 형태소 분석, 정규화 |
NLTK를 이용한 영어 토큰화 예시:
from nltk.tokenize import sent_tokenize, word_tokenize

text = "I love AI. Natural Language Processing is interesting."

# 문장 단위 토큰화
sentences = sent_tokenize(text)

# 단어 단위 토큰화
words = word_tokenize(text)

print(sentences)
print(words)
한국어 NLP에서는 단순히 공백으로 나누는 것보다 형태소 분석이나 서브워드 토큰화가 중요한 경우가 많다.
토큰화는 텍스트를 모델이 처리할 수 있는 단위로 분리하는 첫 번째 핵심 단계다.
3. 임베딩(Embedding)
3-1. 정의
임베딩이란 텍스트의 토큰이나 문장을 일정한 크기의 숫자 벡터로 표현하는 방법이다.
컴퓨터가 텍스트 데이터를 수학적으로 처리하고 학습할 수 있도록 문자 정보를 숫자 배열로 변환하는 과정이다.
예를 들어 다음과 같이 표현할 수 있다.
삽살개

↓

[0.11, 0.80, 0.52, 0.76, 0.91]
3-2. 임베딩이 필요한 이유
컴퓨터는 사람, 강아지, 행복이라는 단어를 사람처럼 직접 이해하지 못한다. 따라서 텍스트를 숫자로 표현해야 통계 분석이나 머신러닝, 딥러닝 모델의 입력으로 활용할 수 있다.
임베딩은 단순한 숫자 변환을 넘어 학습 방식에 따라 단어 또는 문장의 의미적 특성과 문맥 정보를 벡터 공간에 표현할 수 있다.
3-3. 임베딩의 주요 종류
① CountVectorizer
BoW(Bag of Words)를 기반으로 문서에 등장하는 단어의 출현 횟수를 계산한다.
- 단어의 등장 횟수를 수치화한다.
- 단어 사전을 기준으로 벡터를 생성한다.
- 구현이 간단하고 결과를 해석하기 쉽다.
- 단어의 문맥이나 의미적 관계를 직접 반영하지 못한다.
② TF-IDF
TF-IDF는 단순히 단어의 출현 횟수만 계산하는 것이 아니라, 전체 문서에서 해당 단어가 얼마나 흔하게 등장하는지도 고려한다.
자주 등장하는 일반적인 단어는 가중치를 낮추고, 특정 문서에서 상대적으로 중요한 단어는 가중치를 높인다.
↓ 가중치 감소
특정 문서에서 중요한 단어
↓ 가중치 증가
TF-IDF는 문서 검색, 키워드 추출, 문서 유사도 분석 등에 활용된다.
③ SentenceTransformer
SentenceTransformer는 문장 전체를 하나의 밀집 벡터(Dense Vector)로 변환하는 데 활용되는 라이브러리다.
문장 임베딩 모델을 사용하면 문장의 의미를 벡터로 표현하고, 벡터 간 유사도를 계산해 의미가 비슷한 문장을 검색할 수 있다.
문장 A → [0.12, 0.85, 0.31, ...]
문장 B → [0.15, 0.82, 0.29, ...]
벡터 차원은 사용하는 모델에 따라 달라진다. 예를 들어 일부 SentenceTransformer 모델은 768차원 벡터를 생성하지만, 모든 모델이 768차원을 사용하는 것은 아니다.
4. 코사인 유사도(Cosine Similarity)
4-1. 정의
코사인 유사도는 두 벡터 사이의 각도를 이용해 벡터가 얼마나 유사한 방향을 가지고 있는지 측정하는 방법이다.
텍스트를 숫자 벡터로 변환했다면, 이제 두 문장의 의미가 얼마나 비슷한지 수학적으로 비교할 수 있다.
4-2. 공식
(A · B) / (||A|| × ||B||)
두 벡터의 내적을 각 벡터의 크기로 나눈 값
- A · B : 두 벡터의 내적
- ||A|| : 벡터 A의 크기
- ||B|| : 벡터 B의 크기
4-3. 결과 해석
| 유사도 | 의미 |
|---|---|
| 1 | 두 벡터의 방향이 동일함 |
| 0 | 두 벡터가 직교함 |
| -1 | 두 벡터의 방향이 정반대임 |
일반적인 코사인 유사도의 수학적 범위는 -1부터 1까지다. 다만 CountVectorizer나 TF-IDF처럼 음수가 없는 벡터를 사용하는 경우에는 일반적으로 0부터 1 사이의 값이 나타난다.
또한 유사도 0은 벡터가 직교한다는 뜻이지, 두 문장이 현실적으로 아무런 관련이 없다는 것을 항상 의미하지는 않는다.
4-4. 실제 활용 사례
① 챗봇(ChatBot)
사용자 질문 A:
"이 요리 레시피 알려줘."

사용자 질문 B:
"이 요리 만드는 방법 알려줘."

          ↓

문장 임베딩 생성

          ↓

코사인 유사도 계산

          ↓

의미가 비슷한 질문으로 판단

          ↓

저장된 동일한 답변 반환
표현은 다르지만 의미가 유사한 질문을 찾아 적절한 답변을 반환할 수 있다. 이것이 검색 기반 챗봇의 기본적인 원리다.
② 추천 시스템(Recommendation System)
사용자가 선택한 영화
        ↓
영화 설명 및 줄거리 임베딩
        ↓
다른 영화의 벡터와 유사도 계산
        ↓
유사도가 높은 영화 검색
        ↓
추천 결과 제공
영화의 줄거리나 설명을 벡터로 변환하면 사용자가 선택한 영화와 내용이 비슷한 다른 영화를 추천하는 데 활용할 수 있다.
5. 오늘 수업의 핵심 연결
오늘 배운 세 가지 개념은 자연어처리의 가장 기본적인 연결 구조다.
텍스트를 의미 있는 단위로 분리한다.
토큰이나 문장을 숫자 벡터로 변환한다.
벡터 간 방향을 비교해 유사도를 계산한다.
특히 오늘 수업에서 가장 중요하게 이해해야 할 부분은 다음과 같다.
문장을 숫자로 변환하고(임베딩), 숫자로 바뀐 문장들 사이의 유사도를 계산한다.
이 원리를 이해하면 검색 기반 챗봇, 문서 검색, 추천 시스템 등 다양한 NLP 서비스의 기본 구조를 이해할 수 있다.
6. 오늘 학습 전체 키워드 복습
NLP 기초
- 자연어 처리(NLP)
- 토큰화(Tokenization)
- 형태소 분석
- Mecab
- Okt
- NLTK
- 불용어 제거(Stopwords Removal)
- Corpus(말뭉치)
임베딩
- Sparse Representation
- Dense Representation
- BoW(Bag of Words)
- CountVectorizer
- TF-IDF
- Embedding
- Word Embedding
- Sentence Embedding
유사도
- Cosine Similarity
- Text Similarity
- ChatBot
- 추천 시스템
딥러닝 - RNN
- RNN(Recurrent Neural Network)
- BPTT(Backpropagation Through Time)
- Vanishing Gradient
- Long-Term Dependency
Transformer
- Self-Attention
- Query
- Key
- Value
- Attention Score
- Attention Weight
- Contextual Embedding
BERT
- Encoder
- MLM(Masked Language Model)
- NSP(Next Sentence Prediction)
- CLS
- SEP
- Segment Embedding
- Position Embedding
GPT
- Decoder
- Language Model
- Next Token Prediction
- Text Generation
SentenceTransformer
- 문장 임베딩
- Mean Pooling
- Cosine Similarity
- 문장 검색
- 검색 기반 챗봇
Hugging Face
- pipeline()
- text-classification
- sentiment analysis
- text-generation
- inference
7. 오늘 한 줄 요약
토큰화로 텍스트를 나누고 → 임베딩으로 숫자 벡터로 변환하고 → 코사인 유사도로 문장 간 유사성을 계산한다. RNN은 순차 데이터의 관계를 학습하고, Transformer는 Self-Attention으로 문맥을 반영한다. BERT는 양방향 문맥을 활용해 문장을 이해하고, GPT는 다음 토큰을 예측해 새로운 문장을 생성한다.
8. 학습 회고 및 다음 학습 방향
이번 수업을 통해 자연어처리의 기본 개념들이 서로 독립적인 기술이 아니라 하나의 흐름으로 연결되어 있다는 점을 이해할 수 있었다.
특히 텍스트를 벡터로 변환하는 임베딩과 코사인 유사도는 앞으로 챗봇이나 추천 시스템을 구현할 때 직접 활용할 수 있는 핵심 기술이라고 생각한다.
다음에는 단순히 개념을 암기하는 데 그치지 않고, CountVectorizer와 TF-IDF의 검색 결과를 비교하고 SentenceTransformer를 이용한 문장 검색을 직접 구현해 보고자 한다. 또한 Transformer의 Self-Attention 구조를 코드와 수식으로 다시 확인하면서 BERT와 GPT의 차이를 명확하게 정리할 계획이다.
참고 자료
- NLTK 공식 문서
- KoNLPy 공식 문서
- Scikit-learn 텍스트 특성 추출
- Sentence Transformers 공식 문서
- Hugging Face Transformers 공식 문서
#AI캠프 #자연어처리 #NLP #토큰화 #임베딩 #TFIDF #코사인유사도 #RNN #Transformer #BERT #GPT #SentenceTransformer #HuggingFace #챗봇 #추천시스템
```